 Gemini 中文指南
安全设置
Gemini API 提供安全设置,您可以在原型设计阶段进行调整,以确定您的应用程序是否需要或多或少限制性的安全配置。您可以跨四个过滤器类别调整这些设置,以限制或允许某些类型的内容。
本指南介绍了 Gemini API 如何处理安全设置和过滤,以及如何更改应用程序的安全设置。
安全过滤器 #
Gemini API的可调节安全过滤器涵盖以下类别:
类别 | 说明 |
|---|---|
骚扰 | 针对身份和/或受保护属性的负面或有害评论。 |
仇恨言论 | 粗鲁、无礼或亵渎的内容。 |
露骨的性行为 | 包含性行为或其他淫秽内容。 |
危险 | 促进、促进或鼓励有害行为。 |
这些类别定义于 HarmCategory。您可以使用这些过滤器来调整适合您的用例的内容。例如,如果您正在构建视频游戏对话,您可能认为允许更多评级为 危险 由于游戏的性质。
除了可调节的安全过滤器外,Gemini API 还内置针对核心伤害的保护措施,例如危及儿童安全的内容。这些类型的伤害总是被阻挡且无法调整。
内容安全过滤级别 #
Gemini API 将内容不安全的概率级别分类为 HIGH, MEDIUM, LOW, 或 NEGLIGIBLE.
Gemini API 根据内容不安全的概率而不是严重性来阻止内容。考虑这一点很重要,因为某些内容不安全的可能性很低,尽管危害的严重程度仍然很高。例如,比较句子:
- 机器人打了我一拳。
- 机器人把我砍了。
第一句话可能会导致不安全的可能性更高,但您可能会认为第二句话在暴力方面的严重性更高。鉴于此,您必须仔细测试并考虑需要什么适当的阻止级别来支持您的关键用例,同时最大限度地减少对最终用户的伤害。
根据请求进行安全过滤 #
您可以针对向 API 提出的每个请求调整安全设置。当您提出请求时,系统会分析内容并分配安全评级。安全评级包括危害分类的类别和概率。例如,如果内容因骚扰类别概率较高而被屏蔽,则返回的安全评级类别将等于 HARASSMENT 并将伤害概率设置为 HIGH.
由于该模型的固有安全性,需要额外的过滤器 关闭 默认情况下。如果您选择启用它们,您可以将系统配置为根据内容不安全的概率来阻止内容。默认模型行为涵盖大多数用例,因此您应该仅在应用程序需要一致的情况下调整这些设置。
下表描述了您可以为每个类别调整的块设置。例如,如果您将块设置设置为 块数 为 仇恨言论 类别中,所有极有可能是仇恨言论内容的内容都会被屏蔽。但任何概率较低的事情都是允许的。
阈值(Google AI Studio) | 阈值(API) | 说明 |
|---|---|---|
关闭 |
| 关闭安全过滤器 |
不阻止 |
| 无论不安全内容的可能性如何,始终显示 |
块数 |
| 当不安全内容的可能性很高时进行阻止 |
阻止一些 |
| 当不安全内容的可能性中等或较高时阻止 |
阻止大多数 |
| 当不安全内容的可能性低、中或高时阻止 |
N/A |
| 未指定阈值,使用默认阈值进行阻止 |
如果没有设置阈值,则默认块阈值是 关闭 适用于 Gemini 2.5 及更高版本。
您可以为向生成服务发出的每个请求设置这些设置。请参阅 HarmBlockThreshold 详细信息请参考 API。
安全反馈 #
generateContent 返回一个 GenerateContentResponse 其中包括安全反馈。
及时反馈包含在 promptFeedback。如果 promptFeedback.blockReason 设置后,则提示内容被屏蔽。
响应候选人的反馈包含在 Candidate.finishReason 和 Candidate.safetyRatings。如果响应内容被阻止并且 finishReason 是 SAFETY,你可以检查 safetyRatings 了解更多详情。被阻止的内容不会被返回。
调整安全设置 #
本节介绍如何调整 Google AI Studio 和代码中的安全设置。
Google AI Studio #
您可以在 Google AI Studio 中调整安全设置。
点击 安全设置 下 高级设置 在 运行设置 面板打开 运行安全设置 模态。在模式中,您可以使用滑块调整每个安全类别的内容过滤级别:
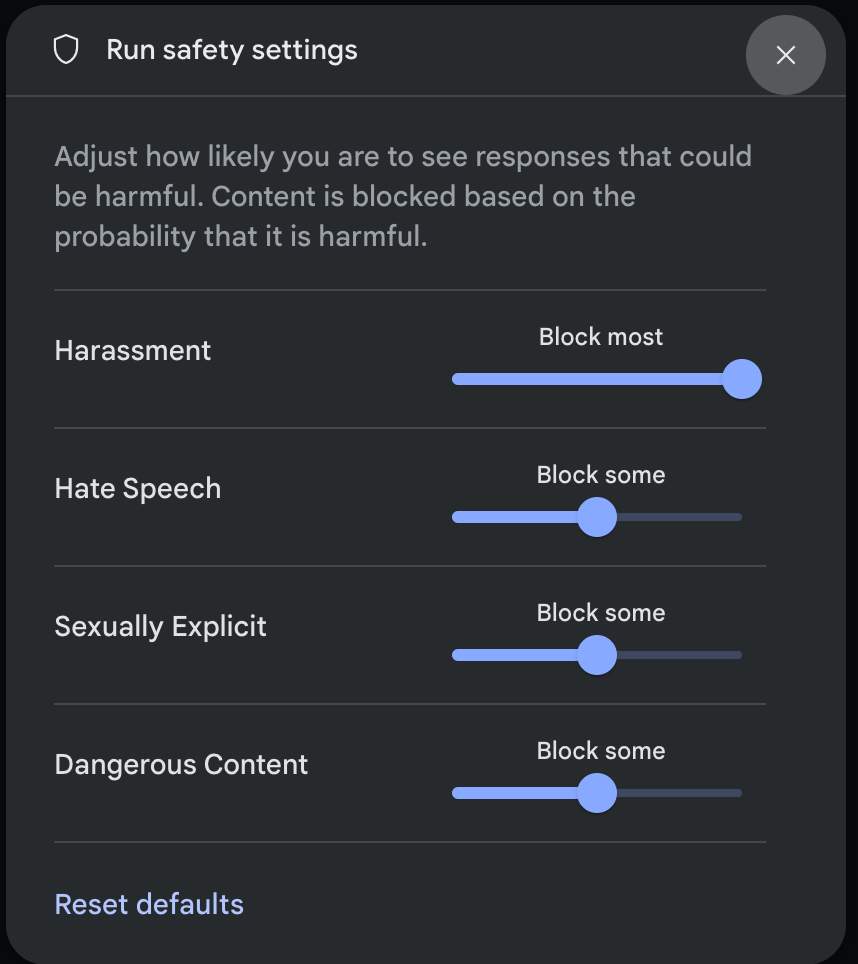
当您发送请求时(例如,通过向模型询问问题),
内容被屏蔽 如果请求的内容被阻止,则会显示消息。要查看更多详细信息,请将指针悬停在 内容被屏蔽 文本查看危害分类的类别和概率。
代码示例 #
以下代码片段展示了如何在您的应用程序中设置安全设置 GenerateContent 打电话。这设定了仇恨言论的阈值(HARM_CATEGORY_HATE_SPEECH) 类别。将此类别设置为 BLOCK_LOW_AND_ABOVE 阻止任何具有较低或较高可能性的仇恨言论的内容。要了解阈值设置,请参阅 根据请求进行安全过滤.
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-4-hydrogen",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category: "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-4-hydrogen",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
import { GoogleGenAI, HarmCategory, HarmBlockThreshold } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: HarmCategory.HARM_CATEGORY_HATE_SPEECH,
    threshold: HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
  },
  {
    category: HarmCategory.HARM_CATEGORY_HARASSMENT,
    threshold: HarmBlockThreshold.BLOCK_MEDIUM_AND_ABOVE,
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-4-hydrogen",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-4-hydrogen", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
后续步骤 #
请参阅 API参考 了解有关完整 API 的更多信息。
回顾 安全指导 大致了解使用法学硕士进行开发时的安全注意事项。
了解有关评估概率与严重性的更多信息 拼图团队
了解有关有助于安全解决方案的产品的更多信息,例如 透视 API.
              * You can use these safety settings to create a toxicity
                  classifier. See the [classification
                  example](https://github.com/google/generative-ai-docs/blob/main/site/en/gemini-api/tutorials/text_classifier_embeddings.ipynb) to
                  get started.