 Gemini 中文指南
使用 Lyria 3.5 生成音乐
Lyria 3.5 是 Google 的音乐生成型号系列,可通过 Gemini API 购买。使用 Lyria 3.5,您可以从文本提示或图像生成高质量的 44.1 kHz 立体声音频。这些模型提供结构连贯性,包括人声、定时歌词和完整的乐器安排。
Lyria 系列包括型号:
| 模型 | 型号编号 | 最适合 | 持续时间 | 输出 |
|---|---|---|---|---|
| Lyria 3 Clip | lyria-3-clip-preview | 短片、循环、预览 | 30 秒 | MP3 |
| Lyria 3.5 | lyria-3.5 | 包含主歌、副歌、桥段的完整歌曲 | 几分钟(可通过提示控制) | MP3 |
两种型号均可使用标准 generateContent 方法和新 Interactions API,支持多模态输入(文本和图像),并生成 44.1 kHz 高保真立体声 音频。
生成音乐剪辑 #
Lyria 3 Clip 模型始终生成 30-第二 剪辑。要生成剪辑,请调用 generateContent 带有文本提示的方法。响应始终包括生成的歌词和歌曲结构以及音频。
  from google import genai

  client = genai.Client()

  response = client.models.generate_content(
      model="lyria-3-clip-preview",
      contents="Create a 30-second cheerful acoustic folk song with "
               "guitar and harmonica.",
  )

  # Parse the response
  for part in response.parts:
      if part.text is not None:
          print(part.text)
      elif part.inline_data is not None:
          with open("clip.mp3", "wb") as f:
              f.write(part.inline_data.data)
          print("Audio saved to clip.mp3")
  import { GoogleGenAI } from "@google/genai";
  import * as fs from "node:fs";

  const ai = new GoogleGenAI({});

  async function main() {
    const response = await ai.models.generateContent({
      model: "lyria-3-clip-preview",
      contents: "Create a 30-second cheerful acoustic folk song with " +
                "guitar and harmonica.",

    });

    for (const part of response.candidates[0].content.parts) {
      if (part.text) {
        console.log(part.text);
      } else if (part.inlineData) {
        const buffer = Buffer.from(part.inlineData.data, "base64");
        fs.writeFileSync("clip.mp3", buffer);
        console.log("Audio saved to clip.mp3");
      }
    }
  }

  await main();
  package main

  import (
      "context"
      "fmt"
      "log"
      "os"

      "google.golang.org/genai"
  )

  func main() {
      ctx := context.Background()
      client, err := genai.NewClient(ctx, nil)
      if err != nil {
          log.Fatal(err)
      }

      result, err := client.Models.GenerateContent(
          ctx,
          "lyria-3-clip-preview",
          genai.Text("Create a 30-second cheerful acoustic folk song " +
                     "with guitar and harmonica."),
          nil,
      )
      if err != nil {
          log.Fatal(err)
      }

      for _, part := range result.Candidates[0].Content.Parts {
          if part.Text != "" {
              fmt.Println(part.Text)
          } else if part.InlineData != nil {
              err := os.WriteFile("clip.mp3", part.InlineData.Data, 0644)
              if err != nil {
                  log.Fatal(err)
              }
              fmt.Println("Audio saved to clip.mp3")
          }
      }
  }
import com.google.genai.Client;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.Part;

import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Paths;

  public class GenerateMusicClip {
public static void main(String[] args) throws IOException {

  try (Client client = new Client()) {
    GenerateContentResponse response = client.models.generateContent(
        "lyria-3-clip-preview",
        "Create a 30-second cheerful acoustic folk song with "
            + "guitar and harmonica.");

    for (Part part : response.parts()) {
      if (part.text().isPresent()) {
        System.out.println(part.text().get());
      } else if (part.inlineData().isPresent()) {
        var blob = part.inlineData().get();
        if (blob.data().isPresent()) {
          Files.write(Paths.get("clip.mp3"), blob.data().get());
          System.out.println("Audio saved to clip.mp3");
        }
      }
    }
  }
}
  }
  curl -s -X POST \
    "https://generativelanguage.googleapis.com/v1beta/models/lyria-3-clip-preview:generateContent" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{
      "contents": [{
        "parts": [
          {"text": "Create a 30-second cheerful acoustic folk song with guitar and harmonica."}
        ]
      }]
    }'
  using System.Threading.Tasks;
  using Google.GenAI;
  using Google.GenAI.Types;
  using System.IO;

  public class GenerateMusicClip {
    public static async Task main() {
      var client = new Client();
      var response = await client.Models.GenerateContentAsync(
        model: "lyria-3-clip-preview",
        contents: "Create a 30-second cheerful acoustic folk song with guitar and harmonica."
      );

      foreach (var part in response.Candidates[0].Content.Parts) {
        if (part.Text != null) {
          Console.WriteLine(part.Text);
        } else if (part.InlineData != null) {
          await File.WriteAllBytesAsync("clip.mp3", part.InlineData.Data);
          Console.WriteLine("Audio saved to clip.mp3");
        }
      }
    }
  }
有关更多示例,请参阅 Lyria 3.5 Notebook 在食谱存储库中。
生成一首完整长度的歌曲 #
使用 lyria-3.5 模型来生成持续几分钟的完整长度的歌曲。 Pro 模型了解音乐结构,可以创作具有独特诗句、副歌和桥段的作品。您可以通过在提示中指定它来影响持续时间(例如,“创建 2 分钟的歌曲”)或使用 时间戳 定义结构。
  response = client.models.generate_content(
      model="lyria-3.5",
      contents="An epic cinematic orchestral piece about a journey home. "
               "Starts with a solo piano intro, builds through sweeping "
               "strings, and climaxes with a massive wall of sound.",
  )
  const response = await ai.models.generateContent({
    model: "lyria-3.5",
    contents: "An epic cinematic orchestral piece about a journey home. " +
              "Starts with a solo piano intro, builds through sweeping " +
              "strings, and climaxes with a massive wall of sound.",

  });
  result, err := client.Models.GenerateContent(
      ctx,
      "lyria-3.5",
      genai.Text("An epic cinematic orchestral piece about a journey " +
                 "home. Starts with a solo piano intro, builds through " +
                 "sweeping strings, and climaxes with a massive wall of sound."),
      nil,
  )
  GenerateContentResponse response = client.models.generateContent(
      "lyria-3.5",
      "An epic cinematic orchestral piece about a journey home. "
          + "Starts with a solo piano intro, builds through sweeping "
          + "strings, and climaxes with a massive wall of sound.");
  curl -s -X POST \
    "https://generativelanguage.googleapis.com/v1beta/models/lyria-3.5:generateContent" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{
      "contents": [{
        "parts": [
          {"text": "An epic cinematic orchestral piece about a journey home. Starts with a solo piano intro, builds through sweeping strings, and climaxes with a massive wall of sound."}
        ]
      }]
    }'
  var response = await client.Models.GenerateContentAsync(
    model: "lyria-3.5",
    contents: "An epic cinematic orchestral piece about a journey home. " +
              "Starts with a solo piano intro, builds through sweeping " +
              "strings, and climaxes with a massive wall of sound."
  );
选择输出格式 #
默认情况下,Lyria 3.5 型号生成音频 MP3 格式。对于Lyria 3.5,您还可以请求输出 WAV (AUDIO_WAV) 通过设置格式化 generationConfig.responseFormat.audio.mimeType 到 "AUDIO_WAV".
  curl -s -X POST \
    "https://generativelanguage.googleapis.com/v1beta/models/lyria-3.5:generateContent" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{
      "contents": [{
        "parts": [
          {"text": "An atmospheric ambient track."}
        ]
      }],
      "generationConfig": {
        "responseModalities": ["AUDIO", "TEXT"],
        "responseFormat": { "audio": { "mimeType": "AUDIO_WAV" } }
      }
    }'
解析响应 #
Lyria 3.5 的响应包含多个部分。文本部分包含生成的歌词或歌曲结构的 JSON 描述。零件有 inline_data 包含音频字节。
重要提示:您不应假设歌词始终是第一部分。始终迭代所有部分并检查每个部分的类型。
  lyrics = []
  audio_data = None

  for part in response.parts:
      if part.text is not None:
          lyrics.append(part.text)
      elif part.inline_data is not None:
          audio_data = part.inline_data.data

  if lyrics:
      print("Lyrics:\n" + "\n".join(lyrics))

  if audio_data:
      with open("output.mp3", "wb") as f:
          f.write(audio_data)
  import { GoogleGenAI } from "@google/genai";
  import * as fs from "node:fs";

  const ai = new GoogleGenAI({});

  async function main() {
    const response = await ai.models.generateContent({
      model: "lyria-3-clip-preview",
      contents: "Create a 30-second cheerful acoustic folk song with " +
                "guitar and harmonica.",

    });

    for (const part of response.candidates[0].content.parts) {
      if (part.text) {
        console.log(part.text);
      } else if (part.inlineData) {
        const buffer = Buffer.from(part.inlineData.data, "base64");
        fs.writeFileSync("clip.mp3", buffer);
        console.log("Audio saved to clip.mp3");
      }
    }
  }

  await main();
  package main

  import (
      "context"
      "fmt"
      "log"
      "os"

      "google.golang.org/genai"
  )

  func main() {
      ctx := context.Background()
      client, err := genai.NewClient(ctx, nil)
      if err != nil {
          log.Fatal(err)
      }

      result, err := client.Models.GenerateContent(
          ctx,
          "lyria-3-clip-preview",
          genai.Text("Create a 30-second cheerful acoustic folk song " +
                     "with guitar and harmonica."),
          nil,
      )
      if err != nil {
          log.Fatal(err)
      }

      for _, part := range result.Candidates[0].Content.Parts {
          if part.Text != "" {
              fmt.Println(part.Text)
          } else if part.InlineData != nil {
              err := os.WriteFile("clip.mp3", part.InlineData.Data, 0644)
              if err != nil {
                  log.Fatal(err)
              }
              fmt.Println("Audio saved to clip.mp3")
          }
      }
  }
  package main

  import (
      "context"
      "fmt"
      "log"
      "os"

      "google.golang.org/genai"
  )

  func main() {
      ctx := context.Background()
      client, err := genai.NewClient(ctx, nil)
      if err != nil {
          log.Fatal(err)
      }

      result, err := client.Models.GenerateContent(
          ctx,
          "lyria-3-clip-preview",
          genai.Text("Create a 30-second cheerful acoustic folk song " +
                     "with guitar and harmonica."),
          nil,
      )
      if err != nil {
          log.Fatal(err)
      }

      for _, part := range result.Candidates[0].Content.Parts {
          if part.Text != "" {
              fmt.Println(part.Text)
          } else if part.InlineData != nil {
              err := os.WriteFile("clip.mp3", part.InlineData.Data, 0644)
              if err != nil {
                  log.Fatal(err)
              }
              fmt.Println("Audio saved to clip.mp3")
          }
      }
  }
  var lyrics = new List<string>();
  byte[] audioData = null;

  foreach (var part in response.Candidates[0].Content.Parts) {
    if (part.Text != null) {
      lyrics.Add(part.Text);
    } else if (part.InlineData != null) {
      audioData = part.InlineData.Data;
    }
  }

  if (lyrics.Count > 0) {
    Console.WriteLine("Lyrics:\n" + string.Join("\n", lyrics));
  }

  if (audioData != null) {
    await File.WriteAllBytesAsync("output.mp3", audioData);
  }
  # The output from the REST API is a JSON object containing base64 encoded data.
  # You can extract the text or the audio data using a tool like jq.
  # To extract the audio and save it to a file:
  curl ... | jq -r '.candidates[0].content.parts[] | select(.inlineData) | .inlineData.data' | base64 -d > output.mp3
从图像生成音乐 #
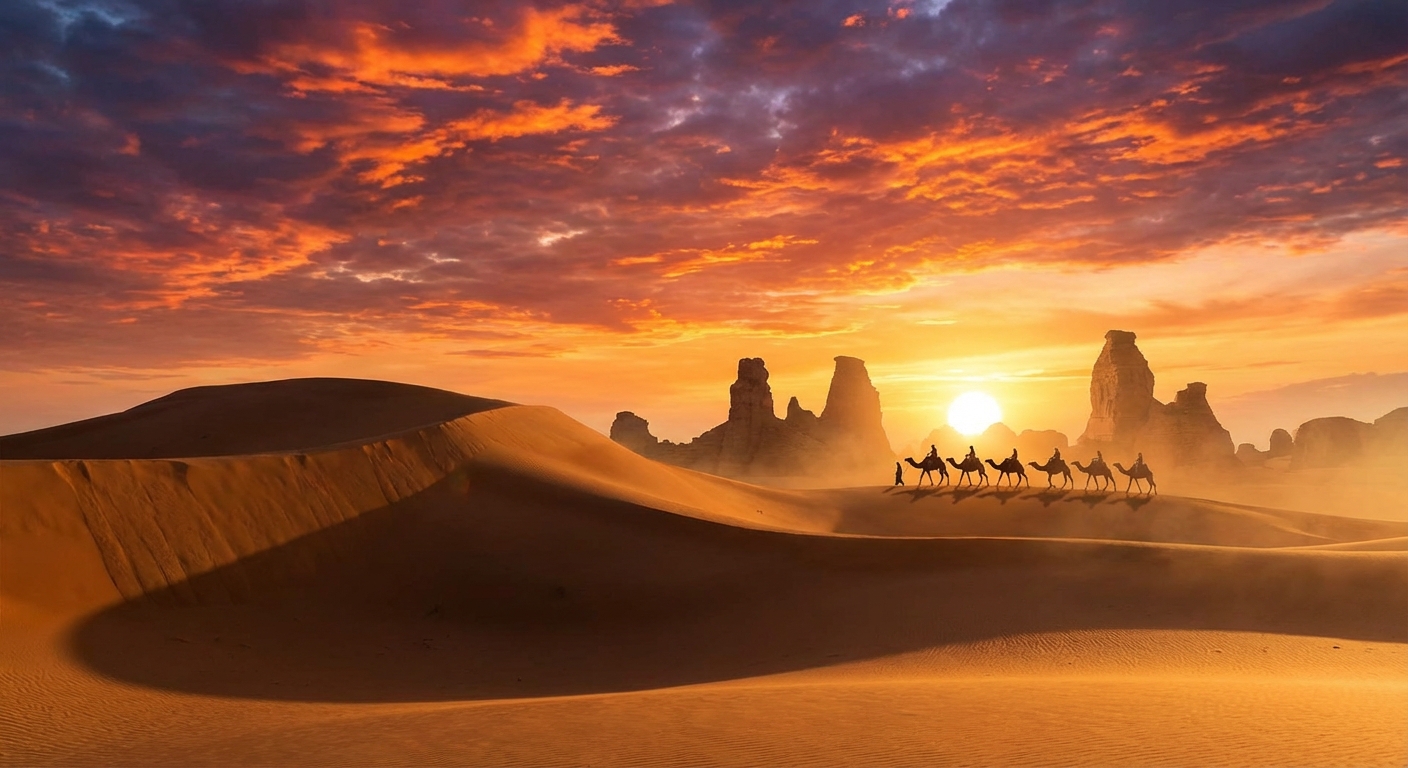
Lyria 3.5 支持多模态输入 - 您最多可以提供 10 图像 除了您的文本提示之外,模型还将根据视觉内容创作音乐。
  from PIL import Image

  image = Image.open("desert_sunset.jpg")

  response = client.models.generate_content(
      model="lyria-3.5",
      contents=[
          "An atmospheric ambient track inspired by the mood and "
          "colors in this image.",
          image,
      ],
  )
import { GoogleGenAI } from '@google/genai';
import * as fs from 'node:fs';

const ai = new GoogleGenAI({});

const imageBytes = fs.readFileSync('desert_sunset.jpg').toString('base64');

const response = await ai.models.generateContent({
  model: 'lyria-3-clip-preview',
  contents: [
    'An atmospheric ambient track inspired by the mood and colors in this image.',
    {
      inlineData: {
        mimeType: 'image/jpeg',
        data: imageBytes,
      },
    },
  ],
});

for (const candidate of response.candidates ?? []) {
  for (const part of candidate.content?.parts ?? []) {
    if (part.text) {
      console.log(part.text);
    } else if (part.inlineData?.data) {
      const buffer = Buffer.from(part.inlineData.data, 'base64');
      fs.writeFileSync('clip.mp3', buffer);
      console.log('Audio saved to clip.mp3');
    }
  }
}
  package main

  import (
      "context"
      "fmt"
      "log"
      "os"

      "google.golang.org/genai"
  )

  func main() {
      ctx := context.Background()
      client, err := genai.NewClient(ctx, nil)
      if err != nil {
          log.Fatal(err)
      }

      result, err := client.Models.GenerateContent(
          ctx,
          "lyria-3-clip-preview",
          genai.Text("Create a 30-second cheerful acoustic folk song " +
                     "with guitar and harmonica."),
          nil,
      )
      if err != nil {
          log.Fatal(err)
      }

      for _, part := range result.Candidates[0].Content.Parts {
          if part.Text != "" {
              fmt.Println(part.Text)
          } else if part.InlineData != nil {
              err := os.WriteFile("clip.mp3", part.InlineData.Data, 0644)
              if err != nil {
                  log.Fatal(err)
              }
              fmt.Println("Audio saved to clip.mp3")
          }
      }
  }
  package main

  import (
      "context"
      "fmt"
      "log"
      "os"

      "google.golang.org/genai"
  )

  func main() {
      ctx := context.Background()
      client, err := genai.NewClient(ctx, nil)
      if err != nil {
          log.Fatal(err)
      }

      result, err := client.Models.GenerateContent(
          ctx,
          "lyria-3-clip-preview",
          genai.Text("Create a 30-second cheerful acoustic folk song " +
                     "with guitar and harmonica."),
          nil,
      )
      if err != nil {
          log.Fatal(err)
      }

      for _, part := range result.Candidates[0].Content.Parts {
          if part.Text != "" {
              fmt.Println(part.Text)
          } else if part.InlineData != nil {
              err := os.WriteFile("clip.mp3", part.InlineData.Data, 0644)
              if err != nil {
                  log.Fatal(err)
              }
              fmt.Println("Audio saved to clip.mp3")
          }
      }
  }
    curl -s -X POST \
      "https://generativelanguage.googleapis.com/v1beta/models/lyria-3.5:generateContent" \
      -H "x-goog-api-key: $GEMINI_API_KEY" \
      -H 'Content-Type: application/json' \
      -d "{
        \"contents\": [{
          \"parts\":[
              {\"text\": \"An atmospheric ambient track inspired by the mood and colors in this image.\"},
              {
                \"inline_data\": {
                  \"mime_type\":\"image/jpeg\",
                  \"data\": \"<BASE64_IMAGE_DATA>\"
                }
              }
          ]
        }]
      }"
    var response = await client.Models.GenerateContentAsync(
      model: "lyria-3.5",
      contents: new List<Part> {
        Part.FromText("An atmospheric ambient track inspired by the mood and colors in this image."),
        Part.FromBytes(await File.ReadAllBytesAsync("desert_sunset.jpg"), "image/jpeg")
      }
    );
提供自定义歌词 #
您可以编写自己的歌词并将其包含在提示中。使用部分标签,例如 [Verse], [Chorus], 和 [Bridge] 帮助模型理解歌曲结构:
    prompt = """
    Create a dreamy indie pop song with the following lyrics:

    [Verse 1]
    Walking through the neon glow,
    city lights reflect below,
    every shadow tells a story,
    every corner, fading glory.

    [Chorus]
    We are the echoes in the night,
    burning brighter than the light,
    hold on tight, don't let me go,
    we are the echoes down below.

    [Verse 2]
    Footsteps lost on empty streets,
    rhythms sync to heartbeats,
    whispers carried by the breeze,
    dancing through the autumn leaves.
    """

    response = client.models.generate_content(
        model="lyria-3.5",
        contents=prompt,
    )
import { GoogleGenAI } from '@google/genai';
import * as fs from 'node:fs';

const ai = new GoogleGenAI({});

const prompt = `
Create a dreamy indie pop song with the following lyrics:

[Verse 1]
Walking through the neon glow,
city lights reflect below,
every shadow tells a story,
every corner, fading glory.

[Chorus]
We are the echoes in the night,
burning brighter than the light,
hold on tight, don't let me go,
we are the echoes down below.

[Verse 2]
Footsteps lost on empty streets,
rhythms sync to heartbeats,
whispers carried by the breeze,
dancing through the autumn leaves.
`;

const response = await ai.models.generateContent({
  model: 'lyria-3-clip-preview',
  contents: prompt,
});

for (const candidate of response.candidates ?? []) {
  for (const part of candidate.content?.parts ?? []) {
    if (part.text) {
      console.log(part.text);
    } else if (part.inlineData?.data) {
      const buffer = Buffer.from(part.inlineData.data, 'base64');
      fs.writeFileSync('clip.mp3', buffer);
      console.log('Audio saved to clip.mp3');
    }
  }
}
    prompt := `
    Create a dreamy indie pop song with the following lyrics:

    [Verse 1]
    Walking through the neon glow,
    city lights reflect below,
    every shadow tells a story,
    every corner, fading glory.

    [Chorus]
    We are the echoes in the night,
    burning brighter than the light,
    hold on tight, don't let me go,
    we are the echoes down below.

    [Verse 2]
    Footsteps lost on empty streets,
    rhythms sync to heartbeats,
    whispers carried by the breeze,
    dancing through the autumn leaves.
    `

    result, err := client.Models.GenerateContent(
        ctx,
        "lyria-3.5",
        genai.Text(prompt),
        nil,
    )
import com.google.genai.Client;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.Part;

import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Paths;

  public class GenerateMusicClip {
public static void main(String[] args) throws IOException {

  try (Client client = new Client()) {
    GenerateContentResponse response = client.models.generateContent(
        "lyria-3-clip-preview",
        "Create a 30-second cheerful acoustic folk song with "

            + "guitar and harmonica.");

    for (Part part : response.parts()) {
      if (part.text().isPresent()) {
        System.out.println(part.text().get());
      } else if (part.inlineData().isPresent()) {
        var blob = part.inlineData().get();
        if (blob.data().isPresent()) {
          Files.write(Paths.get("clip.mp3"), blob.data().get());
          System.out.println("Audio saved to clip.mp3");
        }
      }
    }
  }
}
  }
    var prompt = @"
    Create a dreamy indie pop song with the following lyrics:

    [Verse 1]
    Walking through the neon glow,
    city lights reflect below,
    every shadow tells a story,
    every corner, fading glory.

    [Chorus]
    We are the echoes in the night,
    burning brighter than the light,
    hold on tight, don't let me go,
    we are the echoes down below.

    [Verse 2]
    Footsteps lost on empty streets,
    rhythms sync to heartbeats,
    whispers carried by the breeze,
    dancing through the autumn leaves.
    ";

    var response = await client.Models.GenerateContentAsync(
      model: "lyria-3.5",
      contents: prompt
    );
  curl -s -X POST \
    "https://generativelanguage.googleapis.com/v1beta/models/lyria-3.5:generateContent" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{
      "contents": [{
        "parts": [
          {"text": "Create a dreamy indie pop song with the following lyrics: ..."}
        ]
      }]
    }'
控制时序和结构 #
您可以使用时间戳准确指定歌曲中特定时刻发生的情况。这对于控制乐器何时进入、歌词何时传送以及歌曲如何进行非常有用:
    prompt = """
    [0:00 - 0:10] Intro: Begin with a soft lo-fi beat and muffled
                  vinyl crackle.
    [0:10 - 0:30] Verse 1: Add a warm Fender Rhodes piano melody
                  and gentle vocals singing about a rainy morning.
    [0:30 - 0:50] Chorus: Full band with upbeat drums and soaring
                  synth leads. The lyrics are hopeful and uplifting.
    [0:50 - 1:00] Outro: Fade out with the piano melody alone.
    """

    response = client.models.generate_content(
        model="lyria-3.5",
        contents=prompt,
    )
import { GoogleGenAI } from '@google/genai';
import * as fs from 'node:fs';

const ai = new GoogleGenAI({});

const prompt = `
[0:00 - 0:10] Intro: Begin with a soft lo-fi beat and muffled vinyl crackle.
[0:10 - 0:30] Verse 1: Add a warm Fender Rhodes piano melody and gentle vocals singing about a rainy morning.
[0:30 - 0:50] Chorus: Full band with upbeat drums and soaring synth leads. The lyrics are hopeful and uplifting.
[0:50 - 1:00] Outro: Fade out with the piano melody alone.
`;

const response = await ai.models.generateContent({
  model: 'lyria-3-clip-preview',
  contents: prompt,
});

for (const candidate of response.candidates ?? []) {
  for (const part of candidate.content?.parts ?? []) {
    if (part.text) {
      console.log(part.text);
    } else if (part.inlineData?.data) {
      const buffer = Buffer.from(part.inlineData.data, 'base64');
      fs.writeFileSync('clip.mp3', buffer);
      console.log('Audio saved to clip.mp3');
    }
  }
}
    prompt := `
    [0:00 - 0:10] Intro: Begin with a soft lo-fi beat and muffled
                  vinyl crackle.
    [0:10 - 0:30] Verse 1: Add a warm Fender Rhodes piano melody
                  and gentle vocals singing about a rainy morning.
    [0:30 - 0:50] Chorus: Full band with upbeat drums and soaring
                  synth leads. The lyrics are hopeful and uplifting.
    [0:50 - 1:00] Outro: Fade out with the piano melody alone.
    `

    result, err := client.Models.GenerateContent(
        ctx,
        "lyria-3.5",
        genai.Text(prompt),
        nil,
    )
import com.google.genai.Client;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.Part;

import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Paths;

  public class GenerateMusicClip {
public static void main(String[] args) throws IOException {

  try (Client client = new Client()) {
    GenerateContentResponse response = client.models.generateContent(
        "lyria-3-clip-preview",
        "Create a 30-second cheerful acoustic folk song with "

            + "guitar and harmonica.");

    for (Part part : response.parts()) {
      if (part.text().isPresent()) {
        System.out.println(part.text().get());
      } else if (part.inlineData().isPresent()) {
        var blob = part.inlineData().get();
        if (blob.data().isPresent()) {
          Files.write(Paths.get("clip.mp3"), blob.data().get());
          System.out.println("Audio saved to clip.mp3");
        }
      }
    }
  }
}
  }
  var prompt = @"
  [0:00 - 0:10] Intro: Begin with a soft lo-fi beat and muffled
                vinyl crackle.
  [0:10 - 0:30] Verse 1: Add a warm Fender Rhodes piano melody
                and gentle vocals singing about a rainy morning.
  [0:30 - 0:50] Chorus: Full band with upbeat drums and soaring
                synth leads. The lyrics are hopeful and uplifting.
  [0:50 - 1:00] Outro: Fade out with the piano melody alone.
  ";

  var response = await client.Models.GenerateContentAsync(
    model: "lyria-3.5",
    contents: prompt
  );
  curl -s -X POST \
    "https://generativelanguage.googleapis.com/v1beta/models/lyria-3-clip-preview:generateContent" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{
      "contents": [{
        "parts": [
          {"text": "Create a 30-second cheerful acoustic folk song with guitar and harmonica."}
        ]
      }]
    }'
生成乐器曲目 #
对于背景音乐、游戏配乐或任何不需要人声的用例,您可以提示模型生成纯乐器曲目:
  response = client.models.generate_content(
      model="lyria-3-clip-preview",
      contents="A bright chiptune melody in C Major, retro 8-bit "
                "video game style. Instrumental only, no vocals.",
  )
  const response = await ai.models.generateContent({
    model: "lyria-3-clip-preview",
    contents: "A bright chiptune melody in C Major, retro 8-bit " +
              "video game style. Instrumental only, no vocals.",

  });
  result, err := client.Models.GenerateContent(
      ctx,
      "lyria-3-clip-preview",
      genai.Text("A bright chiptune melody in C Major, retro 8-bit " +
                  "video game style. Instrumental only, no vocals."),
      nil,
  )
  GenerateContentResponse response = client.models.generateContent(
      "lyria-3-clip-preview",
      "A bright chiptune melody in C Major, retro 8-bit "
          + "video game style. Instrumental only, no vocals.");
  var response = await client.Models.GenerateContentAsync(
    model: "lyria-3-clip-preview",
    contents: "A bright chiptune melody in C Major, retro 8-bit " +
              "video game style. Instrumental only, no vocals."
  );
  curl -s -X POST \
    "https://generativelanguage.googleapis.com/v1beta/models/lyria-3-clip-preview:generateContent" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{
      "contents": [{
        "parts": [
          {"text": "Create a 30-second cheerful acoustic folk song with guitar and harmonica."}
        ]
      }]
    }'
提示:对于 最好的结果,在提示中明确包含“仅乐器,无人声”。
生成不同语言的音乐 #
Lyria 3.5 以您的提示语言生成歌词。要生成带有法语歌词的歌曲,请用法语编写提示。该模型会调整其声音风格和发音以匹配语言。
  response = client.models.generate_content(
      model="lyria-3.5",
      contents="Crée une chanson pop romantique en français sur un "
                "coucher de soleil à Paris. Utilise du piano et de "
                "la guitare acoustique.",
  )
    const response = await ai.models.generateContent({
      model: "lyria-3.5",
      contents: "Crée une chanson pop romantique en français sur un " +
                "coucher de soleil à Paris. Utilise du piano et de " +
                "la guitare acoustique.",

    });
  result, err := client.Models.GenerateContent(
      ctx,
      "lyria-3.5",
      genai.Text("Crée une chanson pop romantique en français sur un " +
                  "coucher de soleil à Paris. Utilise du piano et de " +
                  "la guitare acoustique."),
      nil,
  )
  GenerateContentResponse response = client.models.generateContent(
      "lyria-3.5",
      "Crée une chanson pop romantique en français sur un "
          + "coucher de soleil à Paris. Utilise du piano et de "
          + "la guitare acoustique.");
  using System.Threading.Tasks;
  using Google.GenAI;
  using Google.GenAI.Types;
  using System.IO;

  public class GenerateMusicClip {
    public static async Task main() {
      var client = new Client();
      var response = await client.Models.GenerateContentAsync(
        model: "lyria-3-clip-preview",
        contents: "Create a 30-second cheerful acoustic folk song with guitar and harmonica."
      );

      foreach (var part in response.Candidates[0].Content.Parts) {
        if (part.Text != null) {
          Console.WriteLine(part.Text);
        } else if (part.InlineData != null) {
          await File.WriteAllBytesAsync("clip.mp3", part.InlineData.Data);
          Console.WriteLine("Audio saved to clip.mp3");
        }
      }
    }
  }
  curl -s -X POST \
    "https://generativelanguage.googleapis.com/v1beta/models/lyria-3.5:generateContent" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{
      "contents": [{
        "parts": [
          {"text": "Crée une chanson pop romantique en français sur un coucher de soleil à Paris. Utilise du piano et de la guitare acoustique."}
        ]
      }]
    }'
模型智能 #
Lyria 3.5 分析您的提示过程,其中模型根据您的提示通过音乐结构(前奏、主歌、合唱、桥段等)进行推理。这是在生成音频之前发生的,并确保结构的连贯性和音乐性。
重要提示:虽然 Lyria 3.5 在内部使用提示重写器来解释自然语言指令,但它确实 不 向用户公开中间的“思想”块或思想签名。
Interactions API #
您可以将 Lyria 3.5 型号与 Interactions API;用于与 Gemini 模型和智能体交互的统一界面。它简化了复杂多模态用例的状态管理和长期运行的任务。
from google import genai
import base64

client = genai.Client()

interaction = client.interactions.create(
    model="lyria-3-clip-preview",
    input="Create a 30-second cheerful acoustic folk song with guitar and harmonica.",
)

for step in interaction.steps:
    if step.type == "model_output":
        for content_block in step.content:
            if content_block.type == "text":
                print(content_block.text)
            elif content_block.type == "audio":
                with open("clip.mp3", "wb") as f:
                    f.write(base64.b64decode(content_block.data))
                print("Audio saved to clip.mp3")
import { GoogleGenAI } from '@google/genai';
import * as fs from 'node:fs';

const ai = new GoogleGenAI({});

const interaction = await ai.interactions.create({
  model: 'lyria-3-clip-preview',
  input: 'Create a 30-second cheerful acoustic folk song with guitar and harmonica.',
});

for (const step of interaction.steps ?? []) {
  if (step.type === 'model_output') {
    for (const contentBlock of step.content ?? []) {
      if (contentBlock.type === 'text') {
        console.log(contentBlock.text);
      } else if (contentBlock.type === 'audio') {
        const buffer = Buffer.from(contentBlock.data, 'base64');
        fs.writeFileSync('clip.mp3', buffer);
        console.log('Audio saved to clip.mp3');
      }
    }
  }
}
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Api-Revision: 2026-05-20" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "lyria-3-clip-preview",
    "input": "Create a 30-second cheerful acoustic folk song with guitar and harmonica."
  }'
提示指南 #
要了解如何针对音乐流派、乐器、歌曲结构、自定义歌词和声音表达风格制作有效的提示,请参阅 Lyria 提示指南.
最佳实践 #
首先使用 Clip 进行迭代。 使用速度越快
lyria-3-clip-preview模型在提交全长生成之前尝试提示lyria-3.5.具体一点。 模糊的提示会产生一般的结果。提及乐器、BPM、调、情绪和结构以获得最佳输出。
匹配您的语言。 以您想要歌词的语言进行提示。
使用部分标签。
[Verse],[Chorus],[Bridge]标签为模型提供了清晰的结构以供遵循。将歌词与说明分开。 提供自定义歌词时,请将它们与您的音乐方向说明明确分开。
限制 #
安全:所有提示均经过安全过滤器检查。触发过滤器的提示将被阻止。这包括请求特定艺术家声音或生成受版权保护的歌词的提示。
水印:所有生成的音频都包含 SynthID 音频水印 用于识别。该水印人耳无法察觉,不会影响聆听体验。
多轮编辑:音乐生成是一个单轮过程。当前版本的 Lyria 3.5 不支持通过多个提示迭代编辑或优化生成的剪辑。
长度:剪辑模型始终生成 30 秒剪辑。 Pro 模型生成的歌曲持续几分钟;确切的持续时间可以通过您的提示来影响。
决定论:即使提示相同,不同调用的结果也可能有所不同。