 Gemini 中文指南
安全性与事实准确性指南
生成式人工智能模型是强大的工具,但它们并非没有局限性。它们的多功能性和适用性有时会导致意想不到的输出,例如不准确、有偏见或令人反感的输出。后处理和严格的手动评估对于限制此类输出造成的危害风险至关重要。
Gemini API 提供的模型可用于各种生成式 AI 和自然语言处理 (NLP) 应用。这些功能只能通过 Gemini API 或 Google AI Studio Web 应用程序使用。您对 Gemini API 的使用还须遵守 生成式人工智能禁止使用政策 和 Gemini API服务条款.
大型语言模型 (LLM) 如此有用的部分原因在于它们是可以解决许多不同语言任务的创造性工具。不幸的是,这也意味着大型语言模型可能会生成您意想不到的输出,包括令人反感的、不敏感的或实际上不正确的文本。更重要的是,这些模型令人难以置信的多功能性也使得很难准确预测它们可能产生什么样的不良输出。虽然 Gemini API 的设计 谷歌的人工智能原则 请记住,开发人员有责任负责任地应用这些模型。为了帮助开发人员创建安全、负责任的应用程序,Gemini API 具有一些内置内容过滤以及跨 4 危害维度的可调整安全设置。请参阅 安全设置 指导以了解更多信息。它还提供启用了 Google 搜索的事实依据,以提高真实性,尽管对于用例更具创造性且不寻求信息的开发人员来说,这可能会被禁用。
本文档旨在向您介绍使用法学硕士时可能出现的一些安全风险,并推荐新兴的安全设计和开发建议。 (请注意,法律法规也可能施加限制,但此类考虑因素超出了本指南的范围。)
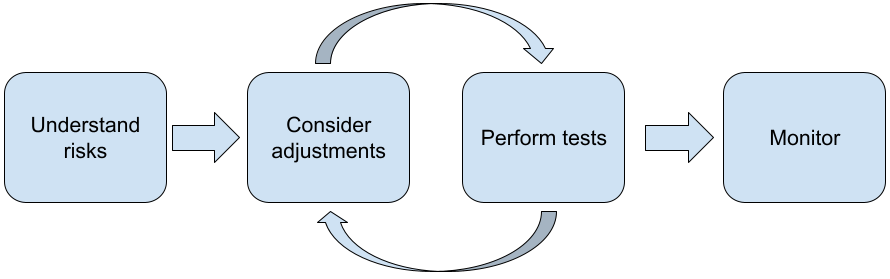
使用法学硕士构建应用程序时,建议执行以下步骤:
- 了解应用程序的安全风险
- 考虑进行调整以降低安全风险
- 执行适合您的用例的安全测试
- 征求用户反馈并监控使用情况
调整和测试阶段应该是迭代的,直到达到适合您的应用程序的性能。
了解您的应用程序的安全风险 #
在这种情况下,安全性被定义为法学硕士避免对其用户造成伤害的能力,例如,通过生成有毒语言或宣扬刻板印象的内容。通过 Gemini API 提供的型号经过设计 谷歌的人工智能原则 记住并且您对它的使用受到 生成式人工智能禁止使用政策。 API内置安全过滤器,帮助解决有毒语言、仇恨言论等一些常见语言模型问题,力求包容、避免刻板印象。然而,每个应用程序都可能给用户带来不同的风险。因此,作为应用程序所有者,您有责任了解您的用户以及您的应用程序可能造成的潜在危害,并确保您的应用程序安全且负责任地使用 LLM。
作为此评估的一部分,您应该考虑可能发生损害的可能性,并确定其严重性和缓解步骤。例如,与生成娱乐虚构故事的应用程序相比,基于事实事件生成文章的应用程序需要更加小心避免错误信息。开始探索潜在安全风险的一个好方法是研究您的最终用户以及可能受您的应用程序结果影响的其他人。这可以采取多种形式,包括研究应用程序领域的最新技术、观察人们如何使用类似的应用程序、进行用户研究、调查或与潜在用户进行非正式访谈。
高级提示 #
与目标人群中的各种潜在用户讨论您的应用程序及其预期目的,以便对潜在风险有更广泛的了解,并根据需要调整多样性标准。
该 人工智能风险管理框架 美国政府国家标准与技术研究院 (NIST) 发布的《人工智能风险管理指南》为人工智能风险管理提供了更详细的指导和额外的学习资源。
DeepMind 的出版物 语言模型造成的道德和社会危害风险 详细描述了语言模型应用程序可能造成损害的方式。
考虑进行调整以减轻安全和事实风险 #
现在您已经了解了风险,您可以决定如何减轻风险。确定要优先考虑哪些风险以及应该采取哪些措施来预防这些风险是一个关键的决定,类似于对软件项目中的错误进行分类。一旦确定了优先级,您就可以开始考虑最合适的缓解措施类型。通常,简单的改变就可以产生影响并降低风险。
例如,在设计应用程序时请考虑:
调整模型输出 更好地反映您的应用程序环境中可以接受的内容。调整可以使模型的输出更加可预测和一致,因此可以帮助减轻某些风险。
提供一种有助于更安全输出的输入方法。 您向法学硕士提供的确切输入可以对输出的质量产生影响。尝试输入提示以找到在您的用例中最安全的方法是非常值得的,因为您可以提供一个有利于它的用户体验。例如,您可以限制用户仅从输入提示的下拉列表中进行选择,或者提供带有描述性短语的弹出建议,您发现这些建议在您的应用程序上下文中可以安全执行。
在向用户显示之前阻止不安全输入并过滤输出。 在简单的情况下,阻止列表可用于识别和阻止提示或响应中的不安全单词或短语,或要求人工审阅者手动更改或阻止此类内容。
使用训练有素的分类器为每个提示贴上潜在危害或对抗性信号的标签。 然后可以根据检测到的损害类型采用不同的策略来处理请求。例如,如果输入本质上是明显的敌对或辱骂性的,它可能会被阻止,而是输出预先编写的响应。 高级提示: 如果信号确定输出有害,应用程序可以采用以下选项:
提供错误消息或预先编写脚本的输出。
再次尝试提示,以防生成替代安全输出,因为有时相同的提示会引发不同的输出。
采取防范措施防止故意滥用 例如为每个用户分配一个唯一的 ID,并对给定时间内可以提交的用户查询量施加限制。另一个保护措施是尝试防止可能的即时注入。提示注入与 SQL 注入非常相似,是恶意用户设计操纵模型输出的输入提示的一种方法,例如,通过发送指示模型忽略任何先前示例的输入提示。请参阅 生成式人工智能禁止使用政策 有关故意滥用的详细信息。
将功能调整为本质上风险较低的东西。 范围较窄的任务(例如,从文本段落中提取关键字)或需要更多人工监督的任务(例如,生成将由人工审核的简短内容)通常会带来较低的风险。例如,您可以将其限制为扩展大纲或建议替代措辞,而不是创建一个应用程序来从头开始编写电子邮件回复。
调整有害内容安全设置,以降低您看到有害回复的可能性。 Gemini API 提供安全设置,您可以在原型设计阶段进行调整,以确定您的应用程序是否需要或多或少的限制性安全配置。您可以跨五个过滤器类别调整这些设置,以限制或允许某些类型的内容。请参阅 安全设置指南 了解通过 Gemini API 提供的可调节安全设置。
通过启用事实依据和 Google 搜索来减少潜在的事实不准确或幻觉。请记住,许多人工智能模型都是实验性的,可能会呈现实际上不准确的信息、产生幻觉或以其他方式产生有问题的输出。具有 Google 搜索功能的事实依据将 Gemini 模型连接到实时 Web 内容,并适用于所有可用语言。这使得 Gemini 能够提供更准确的答案,并引用超出模型知识截止范围的可验证来源。
执行适合您的用例的安全测试 #
测试是构建健壮且安全的应用程序的关键部分,但测试的程度、范围和策略会有所不同。例如,一个只是为了好玩的俳句生成器可能会比一个为律师事务所用来总结法律文件和帮助起草合同而设计的应用程序带来的风险要小一些。但俳句生成器可能被更广泛的用户使用,这意味着对抗性尝试甚至意外有害输入的可能性可能更大。实施背景也很重要。例如,在采取任何行动之前,由人类专家审查其输出的应用程序可能会被认为比没有此类监督的相同应用程序产生有害输出的可能性更小。
在确信自己已准备好启动之前,进行多次更改和测试迭代并不罕见,即使对于风险相对较低的应用程序也是如此。有两种测试对于人工智能应用特别有用:
- 安全标杆管理 涉及设计安全指标,反映应用程序在可能的使用方式下可能不安全的方式,然后使用评估数据集测试应用程序在指标上的性能。最好在测试之前考虑安全指标的最低可接受水平,以便 1) 您可以根据这些期望评估测试结果,并且 2) 您可以根据评估您最关心的指标的测试收集评估数据集。
高级提示:
请注意不要过度依赖“现成的”方法,因为您可能需要使用人工评估者构建自己的测试数据集,以完全适合您的应用程序环境。
如果您有多个指标,您需要决定如果更改导致一个指标的改进却损害另一个指标,您将如何权衡。与其他性能工程一样,您可能希望关注评估集中最坏情况的性能而不是平均性能。
对抗性测试 涉及主动尝试破坏您的应用程序。目标是找出弱点,以便您可以采取适当的措施进行补救。对抗性测试可能需要在您的应用程序中拥有专业知识的评估人员花费大量的时间/精力——但是您做得越多,发现问题的机会就越大,特别是那些很少发生或仅在重复运行应用程序后发生的问题。
对抗性测试是一种系统评估 ML 模型的方法,目的是了解在提供恶意或无意中有害的输入时模型的行为方式:
当输入明显被设计为产生不安全或有害的输出时,输入可能是恶意的——例如,要求文本生成模型生成有关特定宗教的仇恨咆哮。
当输入本身可能无害,但产生有害输出时,输入就会无意中有害——例如,要求文本生成模型描述特定种族的人并收到种族主义输出。
对抗性测试与标准评估的区别在于用于测试的数据的组成。对于对抗性测试,选择最有可能从模型中引发有问题的输出的测试数据。这意味着探究模型的行为是否存在所有可能的危害类型,包括罕见或不寻常的例子以及与安全策略相关的边缘情况。它还应该包括句子不同维度的多样性,例如结构、含义和长度。您可以参考 谷歌负责任的人工智能公平实践 有关构建测试数据集时要考虑的更多详细信息。 高级提示:
使用 自动化测试 而不是招募“红队”人员来尝试破坏您的应用程序的传统方法。在自动化测试中,“红队”是另一种语言模型,它查找会从正在测试的模型中引发有害输出的输入文本。
监控问题 #
无论您进行多少测试和缓解,都无法保证完美,因此请提前计划如何发现和处理出现的问题。常见的方法包括建立一个受监控的渠道,供用户分享反馈(例如,赞成/反对评级),并进行用户研究,主动征求不同用户的反馈——如果使用模式与预期不同,这尤其有价值。
高级提示 #
- 当用户对人工智能产品提供反馈时,随着时间的推移,它可以极大地提高人工智能性能和用户体验,例如帮助您选择更好的示例进行及时调整。的 反馈与控制章节 在 Google 的人员和人工智能指南 强调设计反馈机制时要考虑的关键因素。