 Gemini 中文指南
安全设置
Gemini API 提供安全设置,您可以在原型设计阶段进行调整,以确定您的应用程序是否需要或多或少限制性的安全配置。您可以跨过滤器类别调整这些设置,以限制或允许某些类型的内容。
本指南介绍了如何设置交互的安全设置、内容被阻止时会发生什么以及可以使用哪些类别和阈值。
设置安全设置 #
传递一个列表 safety_settings 当您创建交互时。每个设置都会配对一个危害类别(type)和块阈值(threshold).
以下示例设置仇恨言论(hate_speech) 类别为 block_low_and_above,它会阻止任何具有较低或较高可能性的仇恨言论的内容:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Some potentially unsafe prompt.",
    safety_settings=[
        {
            "type": "hate_speech",
            "threshold": "block_low_and_above",
        }
    ],
)

print(interaction.output_text)
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

async function main() {
  const interaction = await ai.interactions.create({
    model: "gemini-4-hydrogen",
    input: "Some potentially unsafe prompt.",
    safety_settings: [
      {
        type: "hate_speech",
        threshold: "block_low_and_above",
      },
    ],
  });
  console.log(interaction.output_text);
}

await main();
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.HarmCategory;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.SafetySetting;
import com.google.genai.gaos.models.interactions.Threshold;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import java.util.List;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .type(HarmCategory.HATE_SPEECH)
        .threshold(Threshold.BLOCK_LOW_AND_ABOVE)
        .build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-4-hydrogen"))
        .input(InteractionsInput.of("Some potentially unsafe prompt."))
        .safetySettings(List.of(hateSpeechSafety))
        .build();

Interaction interaction =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(interaction.outputText().orElse(""));
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-4-hydrogen"),
            Input: interactions.NewInteractionsInput("Some potentially unsafe prompt."),
            SafetySettings: []interactions.SafetySetting{
                {
                    Type:      interactions.HarmCategoryHateSpeech,
                    Threshold: interactions.ThresholdBlockLowAndAbove,
                },
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }

    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Api-Revision: 2026-05-20" \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Some potentially unsafe prompt.",
    "safety_settings": [
      {"type": "hate_speech", "threshold": "block_low_and_above"}
    ]
  }'
您可以为每个类别添加一项设置。您未设置的类别使用默认阈值,即 关闭 适用于 Gemini 2.5 及更高版本。
当内容被阻止时 #
如果安全过滤器阻止输入或模型的响应,则交互将失败并显示 HTTP 400 错误。被阻止的内容不会被返回。
错误 code 告诉您请求被阻止的原因:
safety:输入或响应被安全过滤器阻止。jailbreak,prohibited_content, 或blocklist: 由于这个原因,输入被阻止。错误message开始于Input blocked:.
例如:
{
  "error": {
    "code": "safety",
    "message": "Request blocked due to safety violations (harmful content). Please modify your input and retry."
  }
}
对于后台交互(background=true), 交互作用 status 设置为 failed,并且相同 code 和 message 出现在其 errors 列表。流式传输时,错误以 error 事件。
安全过滤器 #
Gemini API的可调节安全过滤器涵盖以下类别:
类别 | 值(API) | 说明 |
|---|---|---|
骚扰 |
| 辱骂、威胁或旨在欺凌、折磨或嘲笑的内容。 |
仇恨言论 |
| 基于某些属性宣扬暴力或煽动针对个人或群体的仇恨的内容。 |
露骨的性行为 |
| 包含露骨色情内容的内容。 |
危险 |
| 宣扬、促进或促成危险活动的内容。 |
越狱 |
| 旨在绕过安全过滤器的提示。 |
您可以使用这些过滤器来调整适合您的用例的内容。例如,如果您正在构建视频游戏对话,您可能认为允许更多评级为 危险 由于游戏的性质。
除了可调节的安全过滤器外,Gemini API 还内置针对核心伤害的保护措施,例如危及儿童安全的内容。这些类型的伤害总是被阻挡且无法调整。
区块阈值 #
由于该模型的固有安全性,需要额外的过滤器 关闭 默认情况下。默认模型行为涵盖大多数用例,因此您应该仅在应用程序始终需要时调整这些设置。
下表描述了您可以为每个类别设置的阈值。例如,如果您设置 仇恨言论 到 块数 (block_only_high),仇恨言论可能性高的内容会被屏蔽,而可能性较低的内容则被允许。
阈值(Google AI Studio) | 阈值(API) | 说明 |
|---|---|---|
关闭 |
| 关闭安全过滤器 |
块数 |
| 当不安全内容的可能性很高时进行阻止 |
阻止一些 |
| 当不安全内容的可能性中等或较高时阻止 |
阻止大多数 |
| 当不安全内容的可能性低、中或高时阻止 |
概率与严重性 #
Gemini API 将内容不安全的概率分为高、中、低或可忽略不计。它根据概率而不是损害的严重程度来阻止内容。尽管危害可能很严重,但某些内容不安全的可能性很小。例如,比较这些句子:
- 机器人打了我一拳。
- 机器人把我砍了。
第一句话可能不安全的可能性较高,但您可能会认为第二句话更严重。仔细测试以找到支持您的用例的阻止级别,同时最大限度地减少对最终用户的伤害。
调整 Google AI Studio 中的安全设置 #
点击 安全设置 下 高级设置 在 运行设置 面板打开 运行安全设置 模态。在模式中,您可以使用滑块调整每个安全类别的内容过滤级别:
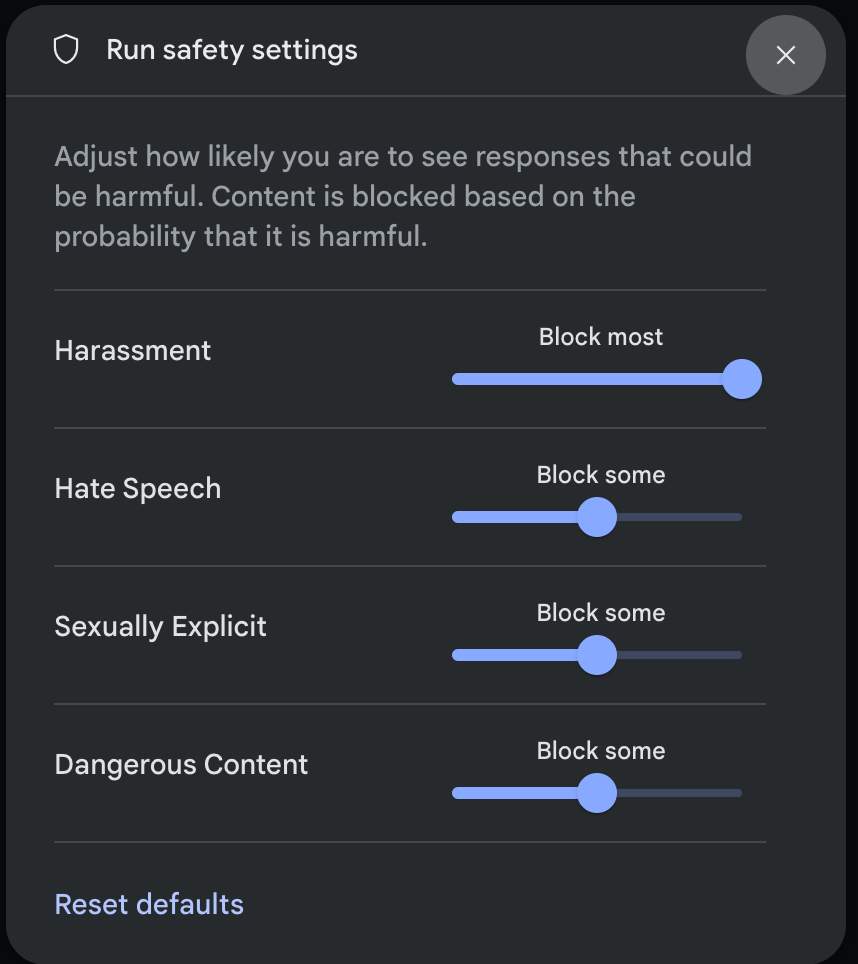
当您发送请求时(例如,通过向模型询问问题),
内容被屏蔽 如果请求的内容被阻止,则会显示消息。要查看更多详细信息,请将指针悬停在 内容被屏蔽 文本查看危害分类的类别和概率。
后续步骤 #
- 请参阅 Interactions API参考 了解有关完整 API 的更多信息。
- 回顾 安全指导 大致了解使用法学硕士进行开发时的安全注意事项。
- 了解有关评估概率与严重性的更多信息 拼图团队.
- 了解有关有助于安全解决方案的产品的更多信息,例如 透视 API.